Gesang aus Lied extrahieren: 4 Methoden im Vergleich
Zusammenfassung
Gesang aus Lied extrahieren gelingt am zuverlässigsten mit einem KI-Stem-Separator wie Demucs. Sie wählen den Zwei-Stem-Modus, exportieren Gesang und Begleitung als WAV und bereinigen danach Hall, Hi-Hats und Zischlaute von Hand. Phasenauslöschung und EQ taugen nur als Notlösung. Ein separierter Gesang eignet sich aber nicht als Sample für einen Stimmklon, weil Artefakte übernommen werden und die Rechte an der Aufnahme beim Rechteinhaber liegen.
Gesang aus Lied extrahieren gelingt im Kern mit einem Schritt: Sie schicken den fertigen Mix durch einen KI-Stem-Separator wie Demucs, wählen die Ausgabe für Gesang und Begleitung und exportieren das Ergebnis als verlustfreie WAV-Datei. Starten Sie mit einer WAV- oder FLAC-Datei, nicht mit einer MP3 in Streaming-Qualität. Rechnen Sie mit einem brauchbaren Acapella in unter zwei Minuten. Ein paar Hallfahnen und Hi-Hat-Übersprechen müssen Sie danach von Hand nacharbeiten.
Das ist die Kurzfassung. Der Rest dieses Artikels zeigt, welche Methode zu welcher Aufgabe passt, was jede Methode hinterlässt und wann das Ergebnis für Ihr Vorhaben nicht gut genug ist.
Welche Methode liefert einen brauchbaren Gesang, und welche verschwendet einen Nachmittag?
Es gibt vier Ansätze, und ihre Qualität liegt weit auseinander. Hier ist unsere Rangfolge aus eigenen Sessions, von der schwächsten bis zur besten Methode bei einem dichten Pop-Mix.
Phasenauslöschung, der bekannte Audacity-Trick mit „Invertieren und Mischen“, funktioniert nur, wenn die Lead-Stimme exakt mittig liegt und Sie eine Instrumentalversion zum Subtrahieren haben. Ohne diese Spur bleibt ein dünnes, hohles Ergebnis zurück. Verwenden Sie das Verfahren nur, wenn Sie den Instrumental-Stem tatsächlich besitzen.
EQ und spektrale Bearbeitung können einen Gesang nach vorn holen, indem Sie 1 bis 4 kHz anheben und unterhalb von 100 Hz absenken. Das ist ein Mischtrick und keine Isolation. Gitarren und Snare liegen weiterhin im selben Frequenzbereich.
Die Center-Kanal-Extraktion, also die bekannten Vocal-Remover-Plug-ins, verfolgt dieselbe Idee mit einer schöneren Oberfläche. Sie scheitert bei jedem Song mit in der Stereobreite verbreiterten Gesangsdoubles oder mit viel Hall.
Die KI-Stem-Separation ist die einzige Methode, die den Gesang als eigene Quelle behandelt. Ein neuronales Netz, das auf Tausenden Mehrspur-Sessions trainiert wurde, sagt Gesang und Rest voraus und subtrahiert dann. In fast allen Fällen ist genau das die richtige Wahl.
Praxishinweis: Wenn Ihnen ein Label die echte Mehrspur oder ein offizielles Acapella schickt, nehmen Sie das. Die Separation ist die Notlösung für Fälle, in denen kein Stem existiert.
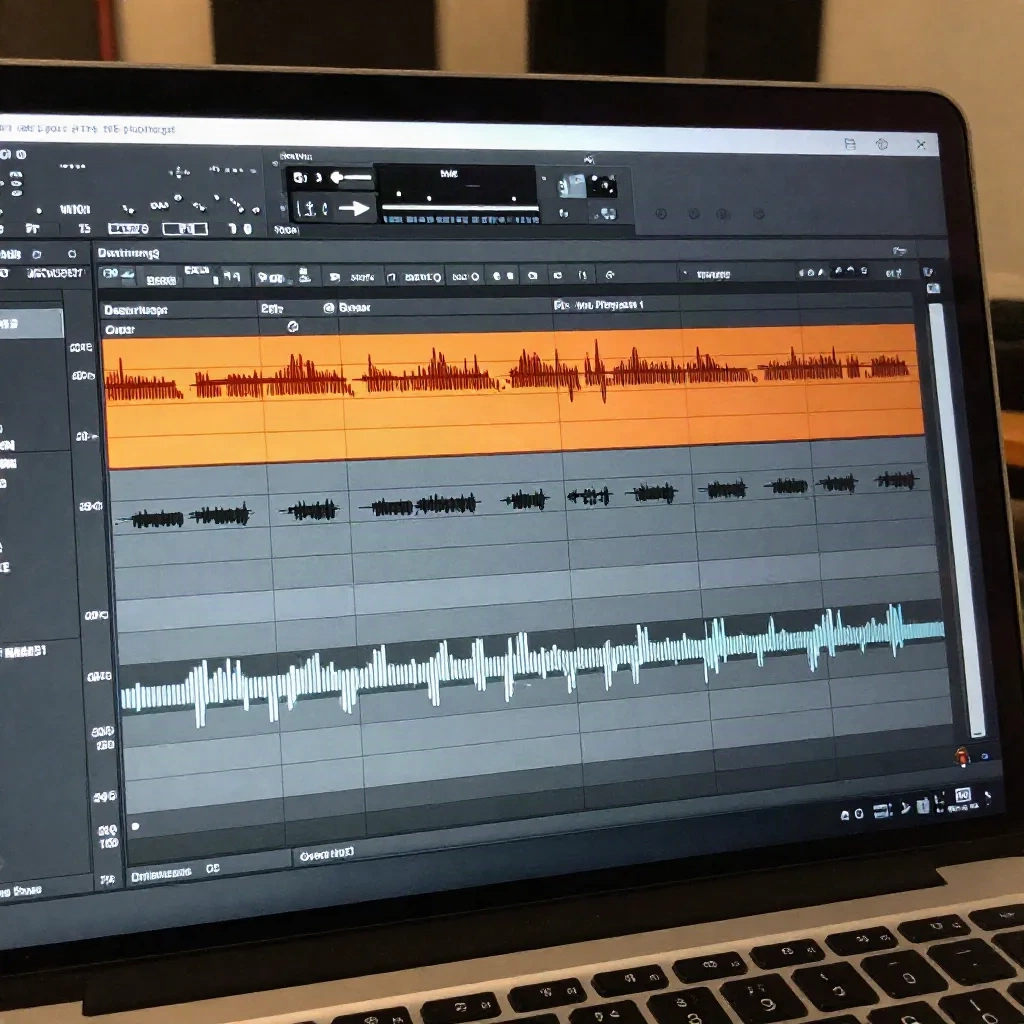
Gesang mit Demucs isolieren, Schritt für Schritt
Demucs stammt aus der Forschungsgruppe von Meta und läuft unter der Haube der meisten Separationsdienste. Die Hybrid-Transformer-Version erreicht im MUSDB-Benchmark mit zusätzlichen Trainingsdaten 9,20 dB Signal-zu-Verzerrungs-Verhältnis (SDR), wie im Paper zu Hybrid Transformers for Music Source Separation beschrieben. Ein höherer SDR-Wert bedeutet weniger Restinstrumente im Gesang und weniger Schäden am Gesang selbst.
Der Ablauf umfasst vier Schritte:
Besorgen Sie die bestmögliche Quelldatei. Eine 16-Bit/44,1-kHz-WAV oder FLAC schlägt jede MP3 mit 128 kbit/s, weil die verlustbehaftete Kodierung genau die Höhen verschmiert hat, die das Modell zum Finden von Konsonanten braucht.
Installieren Sie Demucs lokal mit pip oder nutzen Sie ein Browser-Tool, das es einpackt. Lokale Berechnung hält Ihre Dateien privat und kostet pro Titel nichts.
Führen Sie den Zwei-Stem-Befehl aus:
demucs --two-stems=vocals ihr-song.wav. Beim ersten Lauf laden sich die Modellgewichte herunter, das sind einige hundert Megabyte.Öffnen Sie den Ausgabeordner. Sie erhalten
vocals.wavundno_vocals.wav. Legen Sie beide in Ihre DAW, richten Sie sie bei Sample null aus und prüfen Sie, ob die Summe das Original ergibt.
Auf einem aktuellen Laptop-Prozessor braucht ein vierminütiger Song etwa eine bis drei Minuten. Eine GPU reduziert das auf Sekunden. Die fein abgestimmte Variante htdemucs_ft ist rund viermal langsamer und beim Gesang etwas sauberer. Nutzen Sie sie für alles, was Sie veröffentlichen oder klonen wollen.
Was der isolierte Gesang weiterhin falsch macht
So klingt die Ausgabe im Kontext. Spielen Sie den Gesangs-Stem solo ab, dann hören Sie drei wiederkehrende Artefakte.
Hallfahnen werden abgeschnitten. Das Modell behält den trockenen Gesang und verliert einen großen Teil des Raums, deshalb brechen Phrasenenden abrupt ab. Ein kurzer Faltungshall mit 10 bis 15 Prozent Wet-Anteil bindet sie wieder zusammen.
Hi-Hats und Zischlaute wechseln die Plätze. Becken-Energie um 8 bis 10 kHz sickert in den Gesang, und echte „s“-Laute gehen teilweise verloren. Ein De-Esser bei 6 bis 8 kHz zusammen mit einem sanften dynamischen EQ-Schnitt erledigt den größten Teil davon.
Hintergrundstimmen und Doubles landen im falschen Stem. Das Modell kann nicht wissen, welche Stimme Sie als Lead betrachten. Dicht geschichtete Refrains kommen als eine verschmierte Stimme heraus.
Wer behauptet, das Ergebnis sei sauber, übertreibt. Separation ist eine Schätzung und keine Rückgewinnung der Originalspuren.
Verändern Einstellungen und Quelldatei das Ergebnis wirklich?
Ja, und zwar stärker als die Wahl des Tools. Drei Faktoren bewegen die Qualität spürbar.
Die Quellqualität kommt zuerst. Trennen Sie denselben Song einmal aus einer verlustfreien Datei und einmal aus einer MP3 mit niedriger Bitrate und vergleichen Sie die Gesangs-Stems per Null-Test. Die MP3-Version trägt hörbares Vorecho um Plosive herum, also um harte Laute wie P und T.
Die Modellwahl kommt an zweiter Stelle. Fein abgestimmte Demucs-Varianten und die neueren Band-Split-Modelle tauschen Geschwindigkeit gegen weniger Artefakte. Das ältere Modell Spleeter von Deezer ist schnell und schlank, klingt bei dichten Arrangements aber flacher.
Overlap und Shift-Einstellungen kommen an dritter Stelle. Ein höherer Overlap, der Standard liegt bei 0,25, und zwei bis fünf zufällige Shifts mitteln Artefakte an den Segmentgrenzen aus. Das kostet Rechenzeit. Für einen finalen Export sollten Sie beides erhöhen.
Lässt sich ein isolierter Gesang als Sample für einen Stimmklon nutzen?
Diese Frage stellen unsere Leser am häufigsten. Die kurze Antwort lautet: nur mit Erlaubnis und selten in guter Qualität.
Ein Klon, der auf einem separierten Gesang trainiert wurde, übernimmt dessen Artefakte. Abgeschnittene Hallfahnen und Zischlaut-Übersprechen zeigen sich in der generierten Sprache als seltsame Atemgeräusche oder als Lispeln. Die meisten Klon-Dienste wollen 30 Sekunden bis 3 Minuten trockene, nah am Mikrofon aufgenommene Sprache ohne Musik darunter. Ein separierter Songgesang ist gesungen, bearbeitet und mit Hall versehen. Das ist das Gegenteil davon.
Auch rechtlich ist die Lage eng. Eine kommerzielle Aufnahme ist urheberrechtlich geschützt. Die Stimme einer Sängerin oder eines Sängers genießt je nach Land zusätzlich Schutz über das Persönlichkeitsrecht. In Deutschland schützt das allgemeine Persönlichkeitsrecht auch die Stimme einer Person. Einen Klon nach einem veröffentlichten Track ohne Lizenz zu bauen, ist genau der Anwendungsfall, bei dem Gerichte und Gesetzgeber hinschauen. Verwenden Sie für jeden Klon, den Sie ausliefern, eigene Aufnahmen oder die Aufnahmen einer einwilligenden Person.
Wo die Separation tatsächlich hilft, ist die Bereinigung eigenen Materials. Haben Sie ein Interview über einem Musikbett aufgenommen oder ein Sprachmemo mit laufender Hintergrundmusik, liefert die Separation einen saubereren Ausgangspunkt, bevor Sie irgendein Sample hochladen.
Wann Sie auf KI-Separation ganz verzichten sollten
Verzichten Sie darauf, wenn Sie den echten Stem bekommen können. Viele Künstler veröffentlichen Stems für Remix-Wettbewerbe, und Bandcamp sowie ähnliche Shops verkaufen offizielle Acapellas. Ein echter Stem hat keinerlei Artefakte.
Verzichten Sie auch bei forensischer oder beweisrelevanter Arbeit. Ein separierter Gesang ist die Vermutung eines Modells, und das Modell kann plausible Details erfinden, die nie aufgenommen wurden.
Verzichten Sie außerdem, wenn der Gesang die einzige Stimme im Mix mit derselben Klangfarbe wie die Instrumente ist, etwa ein einzelner Sänger, der eine Synthesizer-Linie doppelt. Das Netz liefert Ihnen beides, vermischt.
Der Aufwand lohnt sich, wenn das Ergebnis ein Übungsplayback ist, ein Sample für einen Remix, den Sie klären wollen, eine Karaoke-Spur oder ein Bereinigungsdurchgang an einer eigenen Aufnahme.
Eine Bereinigungskette für den extrahierten Gesang
Behandeln Sie den Stem wie einen groben Rohmix und nicht wie einen fertigen Track. Diese Reihenfolge verwenden wir bei jeder Extraktion.
Beginnen Sie mit einem Hochpassfilter bei 80 Hz, um das Kick-Übersprechen zu entfernen. Gesang enthält darunter kaum Nützliches, und das Modell lässt oft ein leises Wummern zurück.
Setzen Sie danach ein Werkzeug zur spektralen Reparatur oder einen dynamischen EQ auf den Übersprechbändern ein. Hi-Hat-Übersprechen liegt um 8 bis 10 kHz, Snare-Übersprechen um 200 Hz und 4 kHz. Schneiden Sie nur, während der störende Schlag erklingt, damit der Gesang zwischen den Schlägen seine Luft behält.
Ergänzen Sie dann einen De-Esser bei 6 bis 8 kHz, eine Prise Plate-Hall, um die Ausklänge wieder aufzubauen, und einen leichten Kompressor mit 2:1, der Pegelsprünge glättet, an denen das Modell seine Sicherheit gewechselt hat. Die Eingriffe bleiben klein: 1 bis 3 dB Gain Reduction reichen.
Machen Sie zum Schluss eine Lautheitskontrolle. Isolierte Gesangsspuren klingen leiser als der Originalmix, meist um 6 bis 10 dB. Normalisieren Sie deshalb, bevor Sie sie mit etwas anderem vergleichen.
Praxishinweis: Hören Sie den Stem immer über Kopfhörer und Lautsprecher ab. Artefakte, die über Lautsprecher verschwinden, werden über Kopfhörer hörbar.
Ist die Separation gut genug? Zwei Prüfungen brauchen fünf Minuten. Erstens der Null-Test: Invertieren Sie die Phase der Summe beider Stems gegen das Original. Eine treue Trennung hinterlässt ein sehr leises Restsignal. Zweitens der Solo-Test: Hören Sie den Gesang allein bei moderater Lautstärke und notieren Sie, wo er wabert, denn genau diese Stellen liegen bei jedem Remix offen.
Taucht das Wabern nur im Refrain auf, starten Sie mit höherem Overlap neu oder trennen Sie den Abschnitt gesondert. Zieht es sich durch den ganzen Song, begrenzt die Quelldatei oder das Arrangement das Ergebnis, und keine Einstellung behebt das.
Nicht jede Aufgabe braucht die Kommandozeile. Passen Sie das Werkzeug an die Aufgabe an. Für die Massenbereinigung eigener gesprochener Aufnahmen ist ein transkriptbasierter Editor, der auch Hintergrundmusik entfernt, schneller als eine Stem-Trennung.
Für ein Klon-Sample aus sauberer Sprache nutzen Sie einen Dienst, der 30 Sekunden bis einige Minuten trockenes Audio annimmt und die Qualität meldet, bevor Sie sich festlegen.
Vor Ihrer nächsten Session
Machen Sie einen Test, bevor Sie sich auf einen Workflow festlegen. Nehmen Sie einen Song, den Sie besitzen, trennen Sie ihn mit htdemucs_ft und addieren Sie die beiden Stems wieder. Führen Sie den Null-Test gegen das Original durch. Liegt das Restsignal unter etwa -40 dB, ist die Trennung für die meisten Aufgaben treu genug.
Beheben Sie danach die drei bekannten Probleme der Reihe nach: einen kurzen Hall ergänzen, mit dem De-Esser um 6 bis 8 kHz arbeiten und entscheiden, welche Doubles Sie behalten. Das dauert zehn Minuten und bringt den Gesang von offensichtlich extrahiert zu brauchbar im Mix.
Halten Sie schließlich eine klare Grenze zwischen der Bereinigung eigener Audiodateien und dem Ausleihen fremder Stimmen. Das Erste ist ein Workflow. Das Zweite braucht eine Lizenz.