Cara memisahkan vokal dari lagu: 4 metode dibandingkan
Summary
Cara memisahkan vokal dari lagu: jalankan mix melalui pemisah stem AI seperti Demucs, pilih output vokal dua-stem, lalu ekspor WAV tanpa kompresi. Mulai dari WAV atau FLAC, bukan MP3 streaming. Acapella yang layak pakai bisa jadi dalam kurang dari dua menit, lalu ekor reverb dan bocoran hi-hat dibersihkan secara manual. Phase cancellation dan trik EQ tidak bisa menyamai hasil ini. Gunakan hasilnya untuk audio Anda sendiri atau dengan izin, dan jangan pernah sebagai klon suara tanpa lisensi.
Cara memisahkan vokal dari lagu cukup satu langkah: jalankan seluruh mix melalui pemisah stem AI seperti Demucs, pilih output dua-stem untuk vokal dan iringan, lalu ekspor WAV tanpa kompresi. Mulailah dari rip WAV atau FLAC, bukan MP3 kualitas streaming. Anda akan mendapatkan acapella yang layak pakai dalam kurang dari dua menit, dengan sisa ekor reverb dan bocoran hi-hat yang masih perlu dibersihkan secara manual.
Itu versi singkatnya. Sisa panduan ini membahas metode mana yang cocok untuk tugas apa, apa yang ditinggalkan tiap metode, dan kapan hasilnya belum cukup baik untuk tujuan Anda.
Metode mana yang menghasilkan vokal yang layak pakai, dan mana yang membuang waktu seharian?
Ada empat pendekatan, dan kualitasnya tidak sebanding. Berikut peringkatnya dari yang terburuk ke yang terbaik pada mix pop yang padat, berdasarkan sesi kerja kami sendiri.
Phase cancellation (trik "invert and mix" di Audacity) hanya berhasil jika vokal utama berada tepat di tengah dan Anda punya versi instrumental untuk dikurangkan. Tanpa instrumental itu, hasilnya tipis dan berongga. Lewati metode ini kecuali Anda memang memiliki stem instrumental.
EQ dan editing spektral bisa memajukan vokal dengan menaikkan 1 sampai 4 kHz dan memotong di bawah 100 Hz. Itu trik mixing, bukan isolasi. Gitar dan snare tetap berada di pita frekuensi yang sama.
Center-channel extraction (plugin "vocal remover" lama) memakai ide yang sama dengan antarmuka yang lebih rapi. Metode ini gagal pada lagu dengan dubel vokal yang dilebarkan secara stereo atau yang diberi reverb.
Pemisahan stem AI adalah satu-satunya metode yang memperlakukan vokal sebagai sumber tersendiri. Jaringan saraf yang dilatih pada ribuan sesi multitrack memprediksi vokal dan sisanya, lalu melakukan pengurangan. Inilah yang Anda butuhkan hampir di setiap kasus. Untuk lagu dengan aransemen yang lebih jarang, misalnya vokal dengan gitar akustik dan sedikit perkusi, selisih antar metode biasanya lebih kecil. Pemisahan AI tetap unggul, tetapi bocorannya lebih sedikit sehingga pembersihan manual terasa ringan. Selisih besar baru terlihat pada mix pop yang padat, yang menjadi acuan kami di atas.
Catatan sesi: jika label pernah mengirimkan multitrack asli atau acapella resmi, gunakan itu. Pemisahan hanya cadangan saat stem tidak tersedia.
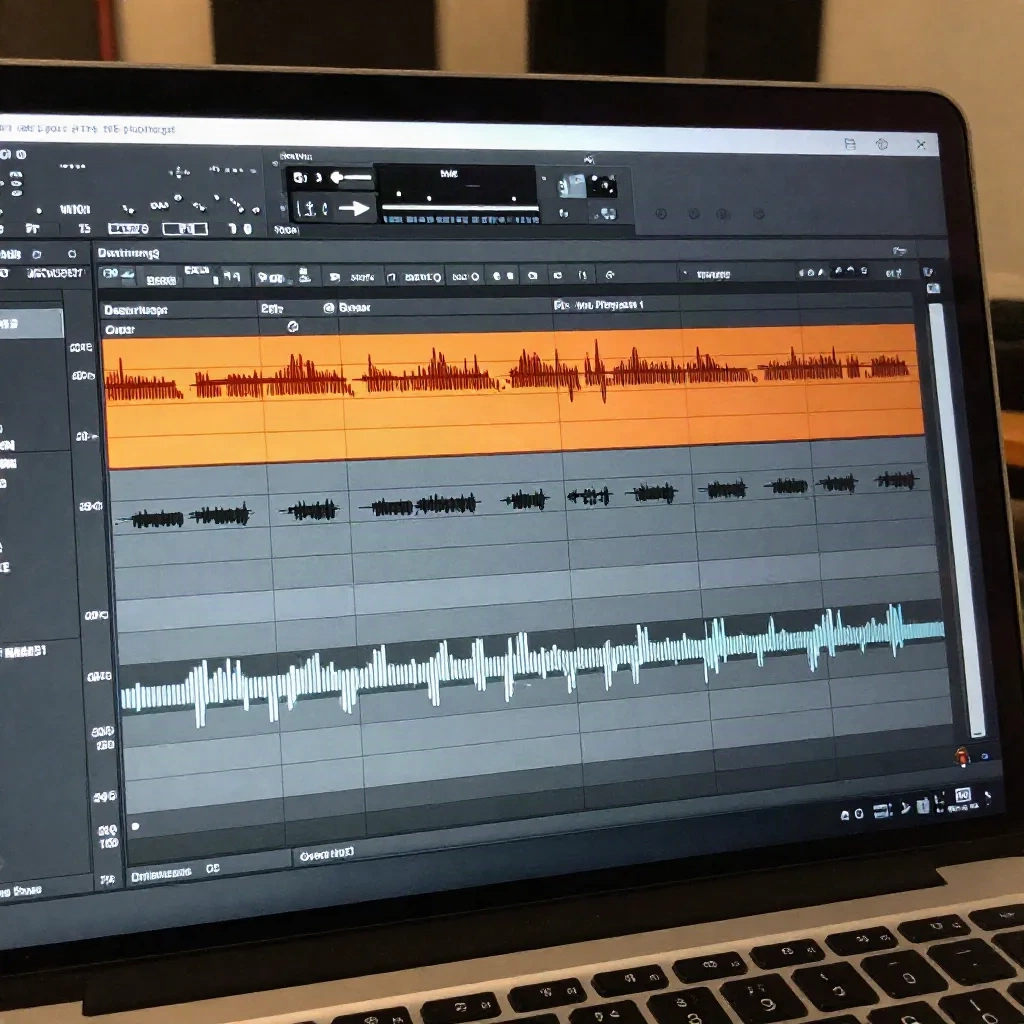
Langkah demi langkah memisahkan vokal dengan Demucs
Demucs, dari grup riset Meta, adalah model open-source yang berada di balik sebagian besar layanan pemisahan. Versi hybrid transformer-nya melaporkan rasio sinyal-ke-distorsi 9.20 dB pada benchmark MUSDB ketika dilatih dengan data tambahan, sebagaimana dijelaskan dalam paper Hybrid Transformers for Music Source Separation. SDR yang lebih tinggi berarti lebih sedikit sisa instrumen di dalam vokal dan lebih sedikit kerusakan pada vokal itu sendiri.
Alurnya ada empat langkah:
Dapatkan file sumber dengan kualitas setinggi mungkin. File WAV atau FLAC 16-bit/44.1 kHz selalu mengungguli MP3 128 kbps, karena encoding lossy sudah merusak konten frekuensi tinggi yang dipakai model untuk menemukan konsonan.
Pasang Demucs secara lokal dengan pip, atau pakai alat browser yang membungkusnya. Menjalankannya secara lokal menjaga file Anda tetap privat dan tanpa biaya per lagu.
Jalankan perintah dua-stem:
demucs --two-stems=vocals lagu-anda.wav. Run pertama akan mengunduh bobot model, yang ukurannya beberapa ratus megabyte.Buka folder output. Anda akan mendapatkan
vocals.wavdanno_vocals.wav. Masukkan keduanya ke DAW, sejajarkan di sample nol, dan periksa apakah menjumlahkannya kembali menghasilkan lagu asli. Beri nama file yang jelas untuk setiap versi, misalnya dengan menyertakan nama model dan nilai overlap, supaya Anda bisa membandingkan hasil tanpa menebak-nebak.
Di CPU laptop modern, lagu 4 menit membutuhkan sekitar satu sampai tiga menit. GPU memangkasnya menjadi hitungan detik. Varian yang di-fine-tune, htdemucs_ft, sekitar empat kali lebih lambat dan sedikit lebih bersih untuk vokal. Gunakan varian ini untuk apa pun yang akan Anda rilis atau jadikan dasar kloning.
Yang masih keliru pada vokal hasil isolasi
Berikut hasil nyatanya dalam konteks. Dengarkan stem vokal secara solo dan Anda akan menemukan tiga artefak yang berulang.
Ekor reverb terpotong. Model mempertahankan vokal kering dan membuang sebagian besar ruangan, sehingga ujung setiap frasa berhenti mendadak. Convolution reverb pendek pada 10 sampai 15 persen wet akan merekatkannya kembali.
Hi-hat dan sibilan saling bertukar tempat. Energi simbal di sekitar 8 sampai 10 kHz bocor ke vokal, dan sebagian bunyi "s" yang asli ikut hilang. De-esser di 6 sampai 8 kHz ditambah potongan dynamic EQ yang lembut menangani sebagian besar masalah ini.
Vokal latar dan dubel masuk ke stem yang salah. Model tidak bisa tahu suara mana yang Anda anggap sebagai vokal utama. Chorus yang bertumpuk rapat keluar sebagai satu vokal yang kabur.
Jangan percaya siapa pun yang bilang hasilnya bersih. Pemisahan adalah estimasi, bukan pemulihan trek asli.
Apakah pengaturan dan file sumber benar-benar mengubah hasilnya?
Ya, dan pengaruhnya lebih besar daripada sekadar pilihan alat. Tiga hal ini paling menentukan.
Kualitas sumber adalah yang utama. Jalankan lagu yang sama dari file lossless dan dari MP3 bitrate rendah, lalu bandingkan stem vokalnya dengan null test. Versi MP3 membawa pre-echo yang terdengar di sekitar bunyi plosif.
Pilihan model menempati urutan kedua. Varian Demucs yang di-fine-tune dan model band-split yang lebih baru menukar kecepatan dengan artefak yang lebih sedikit. Model Spleeter lama dari Deezer cepat dan ringan, tetapi vokalnya terdengar datar pada aransemen yang padat.
Pengaturan overlap dan shift menempati urutan ketiga. Overlap yang lebih tinggi (0.25 secara default) dan dua sampai lima "shift" acak menghilangkan artefak di batas potongan, dengan biaya waktu proses yang lebih lama. Untuk ekspor final, naikkan keduanya.
Bisakah vokal hasil isolasi dipakai sebagai sampel kloning suara?
Ini pertanyaan yang paling sering diajukan pembaca kami. Jawaban singkatnya: hanya dengan izin, dan jarang pada kualitas penuh.
Klon yang dilatih dari vokal hasil pemisahan mewarisi artefaknya. Ekor reverb yang terpotong dan kebocoran sibilan muncul sebagai noise napas yang aneh atau bunyi cadel pada ucapan yang dihasilkan. Sebagian besar layanan kloning meminta 30 detik sampai 3 menit ucapan kering dengan mikrofon dekat dan tanpa musik di bawahnya. Vokal lagu yang sudah dipisahkan justru kebalikannya: dinyanyikan, diproses, dan diberi reverb.
Sisi hukumnya sama ketatnya. Rekaman komersial dilindungi hak cipta, dan suara penyanyi bisa dilindungi oleh hak kepribadian atau hak publisitas, tergantung negaranya. Mengkloning penyanyi dari trek yang sudah dirilis tanpa lisensi adalah kasus yang sedang coba diatur oleh regulator. Gunakan rekaman Anda sendiri, atau pengisi suara yang memberi persetujuan, untuk klon apa pun yang akan Anda rilis. Jika Anda belum yakin apakah sebuah klon boleh dibuat, anggap jawabannya belum, sampai Anda punya izin yang bisa ditunjukkan secara tertulis.
Pemisahan justru berguna untuk membersihkan materi Anda sendiri. Jika Anda merekam wawancara di atas musik latar, atau memo suara dengan trek pengiring yang ikut terputar, pemisahan memberi titik awal yang lebih bersih sebelum Anda mengunggah sampel.
Kapan sebaiknya melewatkan pemisahan AI sepenuhnya?
Lewati jika Anda bisa mendapatkan stem yang asli. Banyak musisi menerbitkan stem untuk kontes remix, dan toko seperti Bandcamp menjual acapella resmi. Stem asli tidak punya artefak sama sekali.
Lewati juga untuk pekerjaan forensik atau pembuktian. Vokal hasil pemisahan adalah tebakan model, dan model bisa mengarang detail yang terdengar masuk akal. Di rekaman lapangan yang banyak suara tumpang tindih, hasil pemisahan sering kali lebih sulit dipakai daripada merekam ulang dari awal.
Lewati saat vokal adalah satu-satunya elemen dalam mix dengan timbre yang sama dengan instrumen, misalnya penyanyi tunggal yang mendobel lini synth. Jaringan akan memberi Anda keduanya, sudah tercampur.
Layak dicoba saat hasilnya dipakai untuk trek latihan, sampel untuk remix yang akan Anda urus lisensinya, track karaoke, atau pass pembersihan pada rekaman Anda sendiri.
Rantai pembersihan untuk vokal hasil ekstraksi
Perlakukan stem seperti bounce kasar, bukan trek jadi. Ini urutan yang kami pakai di setiap ekstraksi.
Mulai dengan high-pass filter di 80 Hz untuk membuang bleed kick. Vokal hampir tidak membawa informasi berguna di bawah frekuensi itu, dan model sering meninggalkan dentuman rendah yang samar.
Berikutnya, gunakan alat repair spektral atau dynamic EQ pada pita kebocoran. Bleed hi-hat ada di sekitar 8 sampai 10 kHz, bleed snare di sekitar 200 Hz dan 4 kHz. Potong hanya saat pukulan yang bermasalah sedang berbunyi, supaya vokal tetap punya udara di antara pukulan.
Lalu tambahkan de-esser di 6 sampai 8 kHz, sedikit plate reverb untuk membangun kembali ekornya, dan kompresor ringan 2:1 untuk meratakan lonjakan level di titik ketika model mengubah tingkat keyakinannya. Perubahannya harus kecil: pengurangan gain 1 sampai 3 dB sudah cukup.
Tutup dengan pengecekan loudness. Vokal hasil isolasi terdengar lebih pelan daripada mix asli, biasanya selisihnya 6 sampai 10 dB, jadi normalisasikan dulu sebelum membandingkannya dengan apa pun.
Catatan sesi: selalu dengarkan stem di headphone dan di speaker. Artefak yang hilang di speaker sering muncul di headphone.
Apakah pemisahannya sudah cukup baik? Dua pengecekan memakan waktu lima menit. Pertama, null test: balikkan fase hasil penjumlahan kedua stem terhadap file asli. Pemisahan yang setia meninggalkan residu yang sangat pelan. Kedua, solo test: dengarkan vokal sendirian pada volume sedang dan catat di mana ia bergetar (warble), karena titik itu akan terdengar jelas di remix mana pun.
Jika warble hanya ada di chorus, jalankan ulang dengan overlap yang lebih tinggi, atau pisahkan bagian itu secara terpisah. Jika muncul di seluruh lagu, sumber atau aransemennya adalah batasnya, dan pengaturan apa pun tidak akan memperbaikinya.
Tidak semua hal perlu command line. Pilih alat yang sesuai dengan tugasnya.
Untuk pembersihan batch rekaman bicara sendiri, editor berbasis transkrip yang juga menghapus musik latar lebih cepat daripada pemisahan stem.
Untuk membuat sampel kloning dari ucapan yang bersih, pakai layanan yang menerima 30 detik sampai beberapa menit audio kering dan melaporkan kualitasnya sebelum Anda berkomitmen.
Sebelum sesi Anda berikutnya
Jalankan satu tes sebelum berkomitmen pada sebuah alur kerja. Ambil lagu yang Anda miliki, pisahkan dengan htdemucs_ft, lalu jumlahkan kedua stem kembali. Null-kan hasilnya terhadap aslinya. Jika residunya berada di bawah sekitar -40 dB, pemisahan itu cukup setia untuk sebagian besar pekerjaan.
Lalu perbaiki tiga masalah yang sudah diketahui, berurutan: tambahkan reverb pendek, de-esser di sekitar 6 sampai 8 kHz, dan tentukan dubel mana yang akan dipertahankan. Itu memakan sepuluh menit dan membuat vokal berpindah dari "jelas hasil ekstraksi" menjadi layak dipakai dalam mix.
Catat hasil tes Anda dalam satu lembar sederhana: model yang dipakai, nilai overlap, hasil null test, dan catatan titik warble. Setelah tiga atau empat lagu, pola pengaturan terbaik untuk materi Anda akan terlihat dengan sendirinya.
Terakhir, jaga garis yang jelas antara membersihkan audio Anda sendiri dan meminjam suara orang lain. Yang pertama adalah alur kerja. Yang kedua memerlukan lisensi.