Zang isoleren uit een nummer: welke methode echt werkt
Samenvatting
Zang isoleren uit een nummer doe je het snelst met een AI-stemscheider zoals Demucs. Kies de tweestemuitvoer, start met een verliesvrij bestand en reken op een bruikbare acapella binnen twee minuten. Galmstaarten en hi-hat-overloop blijven hangen en vragen om een korte opschoonketen met een de-esser en een zachte EQ-snede. Voor een stemkloon is een gescheiden zang zelden geschikt, en dan alleen met toestemming van de zanger.
Zang isoleren uit een nummer doe je met één zet: haal de volledige mix door een AI-stemscheider zoals Demucs, kies de uitvoer met twee stems (zang en begeleiding) en exporteer een verliesvrije WAV. Begin met een WAV- of FLAC-rip, niet met een MP3 van streamingkwaliteit. Reken op een bruikbare acapella binnen twee minuten, met nog wat galm en hi-hat-overloop die je met de hand opschoont.
Dat is de korte versie. De rest van deze gids laat zien welke methode bij welke klus past, wat elke methode achterlaat en wanneer het resultaat niet goed genoeg is voor wat je ermee wilt doen.
Welke methode levert een bruikbare zang op, en welke kost je een middag?
Er bestaan vier benaderingen, en de kwaliteit ligt ver uit elkaar. Hieronder de rangschikking uit onze eigen sessies, van slechtst naar best op een dichte popmix.
Fasecancellatie (de Audacity-truc "omkeren en mixen") werkt alleen als de leadzang precies in het midden staat en je een instrumentale versie hebt om van af te trekken. Zonder die instrumentale versie krijg je een dun, hol resultaat. Sla deze methode over, tenzij je de instrumentale stem zelf in bezit hebt.
EQ en spectrale bewerking kunnen een zang naar voren halen door 1 tot 4 kHz te versterken en onder de 100 Hz af te snijden. Dat is een mixtruc, geen isolatie. De gitaren en de snare zitten nog steeds in dezelfde band.
Centerkanaalextractie (de oude "vocal remover"-plug-ins) is hetzelfde idee met een mooiere interface. Het faalt bij elk nummer met verbrede zangdubbels of galm in het stereobeeld.
AI-stemscheiding is de enige methode die de zang als eigen bron behandelt. Een neuraal netwerk, getraind op duizenden multitrack-sessies, voorspelt de zang en de rest en trekt het ene van het andere af. Dit is wat je in bijna elk geval wilt.
Sessienotitie: als een label je ooit de echte multitrack of een officiële acapella stuurt, gebruik die. Scheiding is een noodoplossing voor als er geen stem bestaat.
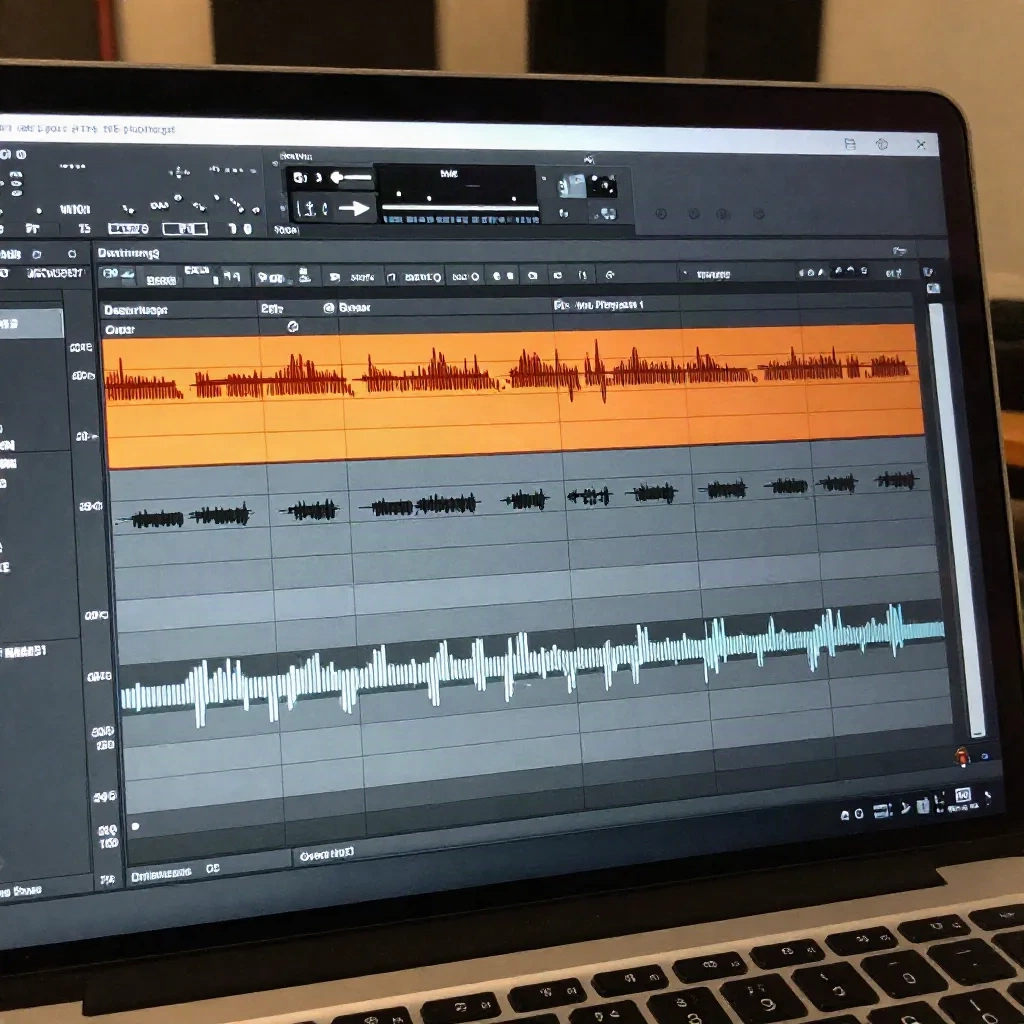
Zang isoleren uit een nummer met Demucs, stap voor stap
Demucs, van de onderzoeksgroep van Meta, is het open-sourcemodel waar de meeste scheidingsdiensten onder de motorkap op draaien. De hybride transformerversie haalt een signaal-ruisverhouding van 9.20 dB op de MUSDB-benchmark wanneer hij met extra trainingsdata draait, zoals beschreven in het paper over Hybrid Transformers for Music Source Separation. Een hogere SDR betekent minder achtergebleven instrument in de zang en minder schade aan de zang zelf.
De workflow bestaat uit vier stappen:
Haal het bronbestand met de hoogste kwaliteit dat je hebt. Een 16-bit/44.1 kHz WAV of FLAC klopt een MP3 van 128 kbps altijd, omdat lossy codering de hoge frequenties al heeft uitgesmeerd waarmee het model medeklinkers vindt.
Installeer Demucs lokaal met pip, of gebruik een browsertool die het inpakt. Lokale runs houden je bestanden privé en kosten niets per track.
Voer het tweestemcommando uit:
demucs --two-stems=vocals your-song.wav. De eerste keer downloadt het model de gewichten, een paar honderd megabyte.Open de uitvoermap. Je krijgt
vocals.wavenno_vocals.wav. Zet beide in je DAW, lijn ze uit op sample nul en controleer of optellen het origineel reproduceert.
Op een moderne laptop-cpu duurt een nummer van vier minuten ongeveer één tot drie minuten. Een gpu brengt dat terug naar seconden. De fijngestemde variant htdemucs_ft is ongeveer vier keer trager en iets schoner op zang. Gebruik die voor alles wat je wilt uitbrengen of klonen.
Wat de geïsoleerde zang nog fout doet
Dit is hoe het resultaat in context echt klinkt. Solo de zangstem en je hoort drie terugkerende artefacten.
Galmstaarten worden afgehakt. Het model houdt de droge zang en laat veel van de ruimte weg, dus het einde van elke frase stopt abrupt. Een korte convolutiegalm van 10 tot 15 procent wet plakt het weer vast.
Hi-hats en sisklanken wisselen van plaats. Cymbaalenergie rond 8 tot 10 kHz lekt in de zang, en sommige echte s-klanken lekken eruit. Een de-esser op 6 tot 8 kHz plus een zachte dynamische EQ-snede lost het meeste op.
Achtergrondzang en dubbels belanden in de verkeerde stem. Het model kan niet weten welke stem jij de leadzang noemt. Zwaar gestapelde refreinen komen eruit als één uitgesmeerde zang.
Vertrouw niemand die zegt dat het resultaat schoon is. Scheiding is een schatting, geen herstel van de originele sporen.
Maken instellingen en bronbestand echt verschil?
Ja, en meer dan de keuze van het gereedschap. Drie dingen verzetten de boel.
Bronkwaliteit komt eerst. Draai hetzelfde nummer één keer van een verliesvrij bestand en één keer van een MP3 met lage bitrate, en vergelijk de zangstems met een nulltest. De MP3-versie draagt hoorbare pre-echo rond plosieven.
Modelkeuze komt op de tweede plaats. Fijngestemde Demucs-varianten en de nieuwere band-split-modellen ruilen snelheid in voor minder artefacten. Het oudere Spleeter-model van Deezer is snel en licht, maar de zang klinkt platter bij een drukke arrangement.
Overlap- en shiftinstellingen komen op de derde plaats. Een hogere overlap (standaard 0.25) en twee tot vijf willekeurige shifts middelen grensartefacten weg, ten koste van de looptijd. Voor een definitieve export verhoog je beide.
Kun je een geïsoleerde zang gebruiken als stemkloon-sample?
Hier vragen onze lezers meestal naar. Kort antwoord: alleen met toestemming, en zelden op volle kwaliteit.
Een kloon die op een gescheiden zang is getraind, erft de artefacten. Afgehakte galmstaarten en sisleakage duiken op als vreemde ademgeluiden of lispelen in de gegenereerde spraak. De meeste klonediensten willen 30 seconden tot 3 minuten droge spraak, van dichtbij opgenomen, zonder muziek eronder. Een gescheiden zang uit een nummer is gezongen, bewerkt en met galm, en dat is precies het tegenovergestelde.
De juridische kant is even strak. Een commerciële opname is auteursrechtelijk beschermd, en de stem van de zanger kan vallen onder persoonlijkheids- of publiciteitsrechten, afhankelijk van het land. Een zanger klonen op basis van een uitgebrachte track zonder licentie is precies het gebruik waar toezichthouders regels voor schrijven. Gebruik je eigen opnames of een instemmende performer voor elke kloon die je uitbrengt.
Waar isolatie wel helpt, is bij het opschonen van je eigen materiaal. Heb je een interview opgenomen over een muziekbed, of een spraakmemo met een achtergrondtrack die meespeelt, dan geeft scheiding een schoner startpunt voordat je een sample uploadt.
Wanneer sla je AI-scheiding helemaal over?
Sla het over als je de echte stem kunt krijgen. Veel artiesten publiceren stems voor remixwedstrijden, en bandcamp en vergelijkbare winkels verkopen officiële acapella's. Een echte stem heeft helemaal geen artefacten.
Sla het over voor forensisch of bewijsmateriaal. Een gescheiden zang is de gok van een model, en die kan plausibele details verzinnen.
Sla het ook over als de zang de enige is in de mix met dezelfde klankkleur als de instrumenten, bijvoorbeeld een losse zanger die een synthlijn verdubbelt. Het netwerk geeft je beide, gemengd.
De moeite waard is het als het resultaat een oefentrack wordt, een sample voor een remix waarvoor je de rechten gaat regelen, een karaokestem, of een opschoonronde op je eigen opname.
Een opschoonketen voor de geëxtraheerde zang
Behandel de stem als een ruwe bounce, niet als een afgewerkt nummer. Dit is de volgorde die wij bij elke extractie gebruiken.
Begin met een high-passfilter op 80 Hz om kickoverloop weg te halen. Zang bevat onder die grens vrijwel niets nuttigs, en het model laat vaak een zwakke laagdreun achter.
Gebruik daarna een spectraal herstelgereedschap of een dynamische EQ op de lekbanden. Hi-hat-overloop zit rond 8 tot 10 kHz, snare-overloop rond 200 Hz en 4 kHz. Snijd alleen zolang de storende slag klinkt, zodat de zang zijn lucht tussen de slagen houdt.
Voeg dan een de-esser toe op 6 tot 8 kHz, een beetje plaatgalm om de staarten te herbouwen, en een lichte compressor op 2:1 om niveausprongen glad te strijken waar het model van zekerheid wisselde. De ingrepen blijven klein: 1 tot 3 dB gain-reductie is ruim voldoende.
Sluit af met een loudnesscheck. Geïsoleerde zang komt meestal 6 tot 10 dB zachter uit dan de originele mix, dus normaliseer voordat je iets vergelijkt.
Sessienotitie: beluister de stem altijd op een koptelefoon en op speakers. Artefacten die op speakers verdwijnen, komen op een koptelefoon juist naar voren.
Is de scheiding goed genoeg? Twee controles kosten vijf minuten. Ten eerste de nulltest: keer de fase om van de som van beide stems ten opzichte van het origineel. Een trouwe splitsing laat een heel zacht restant achter. Ten tweede de solotest: luister naar de zang alleen op een gematigd volume en let op waar hij wiebelt, want die plekken komen in elke remix bloot te liggen.
Als het wiebelen alleen in het refrein zit, draai dan opnieuw met een hogere overlap, of splits die sectie apart. Als het overal zit, is het bronbestand of het arrangement de grens, en geen instelling lost dat op.
Niet alles vraagt om een commandoregel. Kies het gereedschap dat bij de klus past.
Voor batchopschoning van je eigen gesproken opnames is een transcriptgebaseerde editor die ook achtergrondmuziek verwijdert sneller dan een stemscheiding.
Voor het bouwen van een klonesample uit schone spraak gebruik je een dienst die 30 seconden tot enkele minuten droge audio accepteert en de kwaliteit meldt voordat je je vastlegt.
Voor je volgende sessie
Draai één test voordat je je vastlegt op een workflow. Neem een nummer dat je bezit, splits het met htdemucs_ft en tel de twee stems weer op. Maak de nulltest tegen het origineel. Als het restant onder ongeveer -40 dB blijft, is de splitsing trouw genoeg voor de meeste klussen.
Los daarna de drie bekende problemen op, in deze volgorde: voeg een korte galm toe, de-ess rond 6 tot 8 kHz, en beslis welke dubbels je houdt. Dat kost tien minuten en brengt de zang van "duidelijk geëxtraheerd" naar bruikbaar in een mix.
Houd ten slotte een duidelijke grens tussen het opschonen van je eigen audio en het lenen van andermans stem. Het eerste is een workflow. Het tweede vraagt om een licentie.