Jak wyodrębnić wokal z piosenki: 4 metody porównane
Summary
Najszybsza metoda to separacja AI w trybie dwóch stemów, na przykład Demucs, która traktuje wokal jako osobne źródło. Odwracanie fazy, korekcja EQ i ekstrakcja z kanału środkowego dają wyraźnie słabsze wyniki. Wyizolowany wokal wymaga czyszczenia: filtru 80 Hz, de-essera na 6-8 kHz i krótkiego pogłosu. Nie nadaje się jednak na próbkę do klonowania bez zgody wykonawcy.
Jak wyodrębnić wokal z piosenki? Przepuść cały miks przez separator stemów oparty na AI, na przykład Demucs, wybierz wyjście dwóch ścieżek (wokal i podkład) i wyeksportuj wynik jako bezstratny WAV. Zacznij od pliku WAV lub FLAC, a nie od MP3 o jakości streamingu. Spodziewaj się użytecznego akapelli w mniej niż dwie minuty, z ogonami pogłosu i przesłuchami hi-hatów, które trzeba wyczyścić ręcznie.
To wersja skrócona. Reszta artykułu pokazuje, która metoda pasuje do którego zadania, co każda z nich zostawia po sobie i kiedy wynik nie wystarcza do tego, co planujesz z nim zrobić.
Która metoda daje użyteczny wokal, a która marnuje popołudnie?
Istnieją cztery podejścia i ich jakość wyraźnie się różni. Poniżej ranking z naszych sesji, od najsłabszego do najlepszego, na gęstym miksie pop.
Odwracanie fazy (trik z Audacity: „odwróć i zmiksuj") działa tylko wtedy, gdy główny wokal leży idealnie na środku i masz wersję instrumentalną do odjęcia. Bez niej dostajesz cienki, pusty dźwięk. Pomiń tę metodę, chyba że masz już osobny stem podkładu.
Korekcja EQ i edycja spektralna potrafią wysunąć wokal do przodu, podbijając pasmo 1-4 kHz i tnąc poniżej 100 Hz. To jednak sztuczka miksowa, a nie izolacja. Gitary i werbel nadal siedzą w tym samym paśmie.
Ekstrakcja z kanału środkowego (dawne wtyczki typu „vocal remover") to ten sam pomysł w ładniejszym interfejsie. Zawodzi na każdym utworze, w którym wokal ma poszerzone stereo dublowanie albo pogłos.
Separacja stemów przez AI to jedyna metoda, która traktuje wokal jako osobne źródło. Sieć neuronowa wytrenowana na tysiącach sesji wielościeżkowych przewiduje wokal i resztę, a potem odejmuje. W prawie każdym przypadku to właśnie tego potrzebujesz.
Dlaczego sieć działa tam, gdzie filtry zawodzą? Filtr częstotliwościowy zna tylko widmo, czyli to, kiedy dany dźwięk występuje i z jaką mocą. Wokal i gitara elektryczna w tym samym paśmie wyglądają dla niego prawie tak samo. Model wytrenowany na wielościeżkowych sesjach uczy się natomiast kształtu barwy ludzkiego głosu, rytmu fraz i sposobu, w jaki wokal oddycha między wersami. Dlatego potrafi oddzielić źródła, które w zwykłym EQ są nie do rozdzielenia.
To ma też praktyczną konsekwencję. Stare wtyczki typu „vocal remover" tną miks według geometrii stereo, więc każdy element umieszczony w środku, na przykład stopa czy bas, trafia do wokalu. AI nie patrzy na pozycję w panoramie, tylko na zawartość dźwiękową, i właśnie dlatego jej wynik jest tak różny od wszystkiego, co było wcześniej.
Uwaga z sesji: jeśli wytwórnia kiedykolwiek przześle ci prawdziwą sesję wielościeżkową albo oficjalną akapellę, użyj jej. Separacja jest rozwiązaniem awaryjnym, gdy żaden stem nie istnieje.
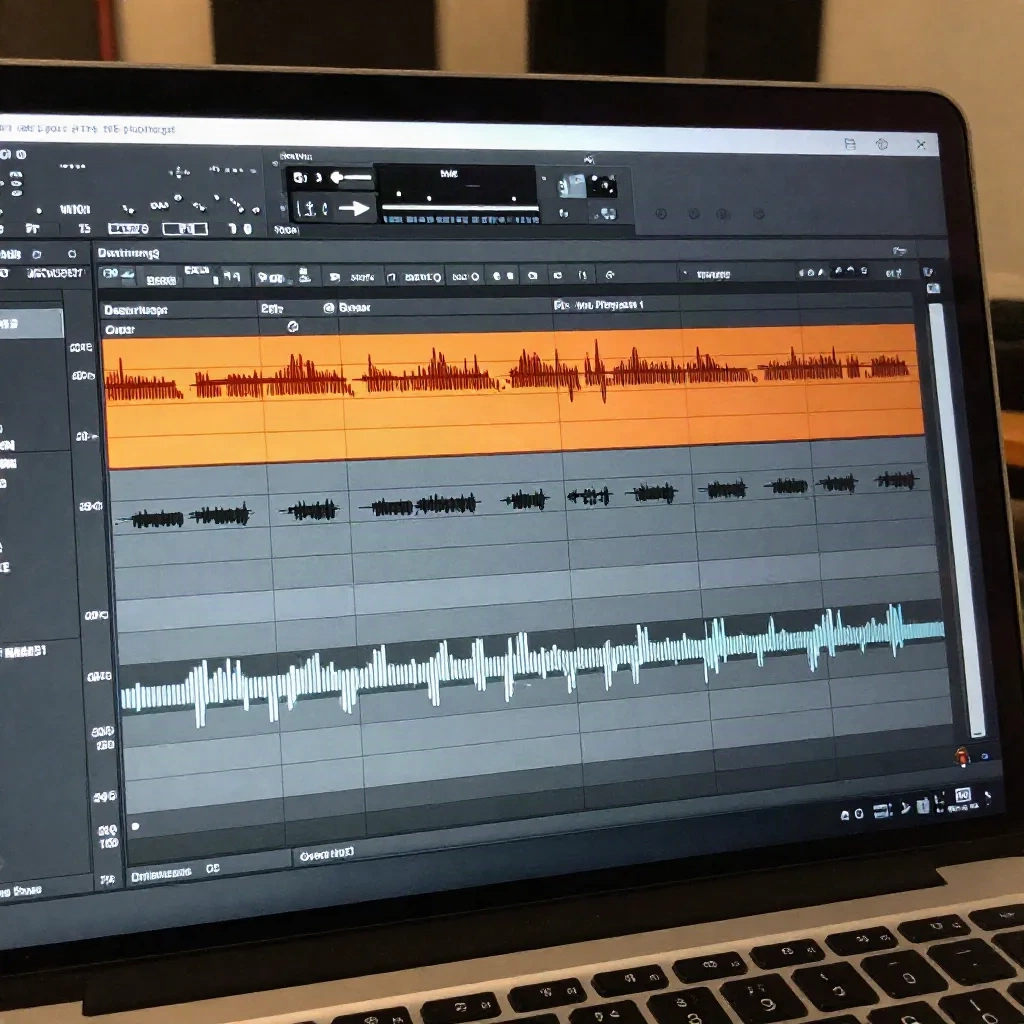
Jak wyodrębnić wokal z piosenki w Demucs krok po kroku
Demucs, opracowany przez grupę badawczą Mety, to model open source, na którym działa większość usług separacji. Wersja z hybrydowym transformerem podaje współczynnik SDR na poziomie 9.20 dB w benchmarku MUSDB, przy treningu z dodatkowymi danymi, jak opisano w artykule o Hybrid Transformers for Music Source Separation. Wyższy SDR oznacza mniej resztek instrumentów w wokalu i mniejsze uszkodzenia samego głosu.
Proces składa się z czterech kroków:
Zdobądź możliwie najlepszy plik źródłowy. WAV lub FLAC w 16 bitach i 44.1 kHz pokonuje za każdym razem MP3 w 128 kbps, bo stratna kompresja już rozmyła wysokie częstotliwości, z których model korzysta, by znaleźć spółgłoski.
Zainstaluj Demucs lokalnie przez pip albo użyj narzędzia w przeglądarce, które go opakowuje. Lokalne uruchomienie chroni twoje pliki i nie kosztuje nic za każdy utwór.
Uruchom polecenie dla dwóch stemów:
demucs --two-stems=vocals twoja-piosenka.wav. Przy pierwszym uruchomieniu pobierane są wagi modelu, które mają kilkaset megabajtów.Otwórz folder wyjściowy. Dostajesz
vocals.wavino_vocals.wav. Wrzuć oba do DAW, ustaw je na próbce zero i sprawdź, czy ich suma odtwarza oryginał.
Na nowoczesnym procesorze laptopa 4-minutowa piosenka zajmuje od minuty do trzech. Karta GPU skraca to do kilku sekund. Dostrojony wariant htdemucs_ft jest mniej więcej czterokrotnie wolniejszy i odrobinę czystszy w wokalu. Używaj go do wszystkiego, co zamierzasz wydać albo sklonować.
Czego wyizolowany wokal nadal nie potrafi
Oto jak wynik brzmi w kontekście. Odsłuchaj sam stem wokalu, a usłyszysz trzy powtarzające się artefakty.
Ogony pogłosu zostają ucięte. Model zachowuje suchy wokal i gubi większość pomieszczenia, więc koniec każdej frazy urywa się nagle. Krótki splot pogłosu na poziomie 10 do 15 procent sygnału mokrego skleja to z powrotem.
Hi-haty i sybilanty zamieniają się miejscami. Energia talerzy w okolicy 8 do 10 kHz przecieka do wokalu, a część prawdziwych głosek „s" ucieka z niego. De-esser na 6 do 8 kHz oraz delikatna dynamiczna korekcja EQ załatwiają większość tego problemu.
Wokale wspierające i dublowania trafiają do złego stemu. Model nie wie, który głos uznać za prowadzący. Mocno nawarstwione refreny wychodzą jako jeden rozmazany wokal.
Nie ufaj nikomu, kto mówi, że wynik jest czysty. Separacja to szacunek, a nie odzyskanie oryginalnych ścieżek.
Najczęściej pomijany problem to pogłos z oryginalnego miksu. Jeśli wokal był mocno zanurzony w pogłosie płytowym albo w długim reverbie halowym, model rozdziela sygnał mokry i suchy w sposób, który nie zawsze jest symetryczny. Efekt widać zwłaszcza w wolnych balladach, gdzie każda fraza ma długi ogon. Po odsłuchu w solo warto sprawdzić, czy ogony nie kończą się szybciej niż w oryginale. Jeśli tak, to nie błąd twojej konfiguracji, tylko cecha wejściowego miksu.
Czy ustawienia i plik źródłowy naprawdę zmieniają wynik?
Tak, i to bardziej niż sam wybór narzędzia. Trzy rzeczy realnie przesuwają wynik.
Jakość źródła jest na pierwszym miejscu. Przepuść ten sam utwór z pliku bezstratnego i z MP3 o niskiej przepływności, a potem porównaj stemy wokalu testem null. Wersja z MP3 niesie słyszalne pre-echo wokół spółgłosek wybuchowych.
Wybór modelu jest na drugim miejscu. Dostrojone warianty Demucsa i nowsze modele z podziałem pasma wymieniają szybkość na mniej artefaktów. Starszy Spleeter z Deezera jest szybki i lekki, ale jego wokale brzmią bardziej płasko przy zajętych aranżacjach.
Ustawienia nakładania i przesunięcia są na trzecim miejscu. Wyższe nakładanie (domyślnie 0.25) oraz od dwóch do pięciu losowych „przesunięć" uśredniają artefakty na granicach fragmentów, kosztem czasu obliczeń. Przy eksporcie finalnym podnieś oba parametry.
Czy wyizolowany wokal nadaje się jako próbka do klonowania głosu?
Na to pytanie odpowiadają nam czytelnicy najczęściej. Krótka odpowiedź: tylko za zgodą i rzadko w pełnej jakości.
Klon wytrenowany na wyodrębnionym wokalu dziedziczy artefakty. Ucięte ogony pogłosu i przecieki sybilantów objawiają się w mowie wygenerowanej jako dziwny szum oddechu albo seplenienie. Większość usług do klonowania chce od 30 sekund do 3 minut suchej, bliskiej mowy bez muzyki pod spodem. Wyodrębniony wokal z piosenki jest zaśpiewany, przetworzony i pogłosowy, czyli dokładnie odwrotnie.
Strona prawna jest równie ścisła. Nagranie komercyjne jest chronione prawem autorskim, a głos wykonawcy może podlegać ochronie praw osobistych albo praw do wizerunku, zależnie od kraju. Klonowanie wokalisty z wydanego utworu bez licencji to przypadek, który regulatorzy właśnie zaczynają opisywać w przepisach. Do każdego klonu, który wypuszczasz, używaj własnych nagrań albo nagrań wykonawcy, który wyraził na to zgodę.
Tam, gdzie izolacja naprawdę pomaga, to czyszczenie własnego materiału. Jeśli nagrałeś wywiad na tle muzyki albo notatkę głosową z grającym podkładem, separacja daje czystszy punkt wyjścia, zanim wgrasz próbkę.
Kiedy w ogóle pominąć separację AI?
Pomiń ją, gdy możesz zdobyć prawdziwy stem. Wielu artystów publikuje stemy do konkursów remixów, a sklepy typu Bandcamp sprzedają oficjalne akapelle. Prawdziwy stem nie ma żadnych artefaktów.
Pomiń ją przy pracy śledczej albo dowodowej. Wyodrębniony wokal to zgadywanie modelu, które potrafi wymyślić wiarygodnie brzmiące szczegóły.
Pomiń ją, gdy wokal to jedyne, co w miksie ma tę samą barwę co instrumenty, na przykład pojedynczy wokalista dublujący linię syntezatora. Sieć da ci oba, wymieszane.
Pomiń ją również wtedy, gdy plan zakłada publikację wokalu bez dalszej pracy i bez możliwości poprawek. Wyizolowany wokal zawsze wymaga słuchu i ręcznej korekty, więc jeśli nie masz czasu na odsłuch na dwóch systemach, lepiej poczekać na prawdziwy stem albo nagrać nową wersję.
Warto się w to zaangażować, gdy wynik ma być ścieżką do ćwiczeń, próbką do remiksu, do którego planujesz uzyskać zgodę, stemem do karaoke albo przebiegiem czyszczącym własne nagranie.
Łańcuch czyszczenia dla wyodrębnionego wokalu
Traktuj stem jak szkic, a nie gotowy utwór. Tak układamy kolejność przy każdej ekstrakcji.
Zacznij od filtra górnoprzepustowego na 80 Hz, żeby usunąć przeciek stopy. Wokal prawie nie niesie czegoś użytecznego poniżej tej granicy, a model często zostawia cichy łomot.
Następnie użyj narzędzia do naprawy spektralnej albo dynamicznej korekcji EQ na pasmach przecieku. Przeciek hi-hatów siedzi w okolicy 8 do 10 kHz, przeciek werbla około 200 Hz i 4 kHz. Tnij tylko wtedy, gdy grający instrument uderza, tak by wokal zachował powietrze między uderzeniami.
Potem dodaj de-esser na 6 do 8 kHz, odrobinę pogłosu płytowego, żeby odbudować ogony, i lekki kompresor 2:1, który wyrówna skoki poziomu w miejscach, gdzie model zmienił pewność. Ruchy mają być małe: od 1 do 3 dB redukcji wystarczy w zupełności.
Na końcu sprawdź głośność. Wyizolowane wokale wychodzą cichsze niż oryginalny miks, zwykle o 6 do 10 dB, więc przed porównaniem z czymkolwiek zrób normalizację.
Uwaga z sesji: zawsze odsłuchuj stem na słuchawkach i na monitorach. Artefakty, które znikają na głośnikach, wychodzą na słuchawkach.
Czy separacja jest wystarczająco dobra? Dwa sprawdzenia zajmują pięć minut. Po pierwsze test null: odwróć fazę sumy obu stemów względem oryginału. Wierny podział zostawia bardzo cichą resztę. Po drugie test solo: odsłuchaj sam wokal przy umiarkowanej głośności i zanotuj miejsca, w których faluje, bo w każdym remiksie te miejsca będą odsłonięte.
Jeśli falowanie siedzi tylko w refrenie, uruchom ponownie z wyższym nakładaniem albo rozdziel tę sekcję osobno. Jeśli występuje wszędzie, granicą są plik źródłowy albo aranżacja i żadne ustawienie tego nie naprawi.
Nie każde zadanie wymaga wiersza poleceń. Dobierz narzędzie do zadania. Do wsadowego czyszczenia własnych nagrań mowy szybszy okazuje się edytor oparty na transkrypcji, który usuwa też muzykę w tle, niż separacja stemów.
Do budowy próbki do klonowania z czystej mowy użyj usługi, która przyjmuje od 30 sekund do kilku minut suchego dźwięku i raportuje jakość, zanim zobowiążesz się do płatności.
Przed następną sesją
Zrób jeden test, zanim wybierzesz przepływ pracy. Weź utwór, do którego masz prawa, rozdziel go przez htdemucs_ft i zsumuj oba stemy. Porównaj sumę z oryginałem testem null. Jeśli reszta leży poniżej około -40 dB, podział jest wystarczająco wierny do większości zadań.
Potem napraw trzy znane problemy po kolei: dodaj krótki pogłos, odsłoń sybilanty na 6 do 8 kHz i zdecyduj, które dublowania zostawiasz. To zajmuje dziesięć minut i przesuwa wokal od „oczywiście wyciągnięty" do użytecznego w miksie.
Na koniec zachowaj wyraźną granicę między czyszczeniem własnego audio a pożyczaniem cudzego głosu. Pierwsze to przepływ pracy. Drugie wymaga licencji.