Isolera sång från en låt: metoder som faktiskt fungerar
Summary
Den snabbaste vägen till en användbar sångstam är AI-separation med Demucs. Kör hela mixen från en förlustfri WAV eller FLAC och få två stammar, vokal och ackompanjemang. Räkna med kapad efterklang och hi-hat-läcka som du städar för hand. Fasannullering och EQ fungerar bara i särskilda fall. Separation ger en gissning, inte en återställning, så använd resultatet för övningsspår, karaoke och egna inspelningar, inte för klonade röster utan tillstånd.
Att isolera sång från en låt handlar om ett enda grepp: kör hela mixen genom en AI-separator som Demucs, välj utdata med två stammar, vokal och ackompanjemang, och exportera en förlustfri WAV. Börja med en WAV- eller FLAC-fil, inte en MP3 i streamingkvalitet. Räkna med en användbar acapella på under två minuter. Viss efterklang och hi-hat-läcka får du städa för hand.
Det är den korta versionen. Resten av guiden går igenom vilken metod som passar vilket jobb, vad varje metod lämnar kvar och när resultatet inte räcker för det du vill göra med det.
Vilken metod ger en användbar vokal, och vilken slösar bort en eftermiddag?
Det finns fyra sätt, och de ligger inte nära varandra i kvalitet. Här är rankingen från våra egna sessioner, från sämst till bäst på en tät popmix.
Fasannullering (Audacity-tricket med "invertera och mixa") fungerar bara om sångstämman sitter exakt i mitten och du har en instrumentalversion att subtrahera. Utan den instrumentalen blir resultatet tunt och ihåligt. Hoppa över den om du inte äger instrumentalstammen.
EQ och spektral redigering kan lyfta fram sången genom att boosta 1 till 4 kHz och skära under 100 Hz. Det är ett mixtrick, inte isolering. Gitarrer och virveltrumma ligger kvar i samma band.
Mittkanalsextraktion (de gamla "vocal remover"-pluginerna) är samma idé i ett snyggare gränssnitt. Den faller på alla låtar med breddade sångdubbleringar eller efterklang.
AI-stemseparation är den enda metoden som behandlar sången som en egen källa. Ett neuralt nätverk tränat på tusentals flerspårssessioner gissar vad som är sång och vad som är resten, och subtraherar sedan. Det är vad du vill ha i nästan alla fall.
Sessionsanteckning: om ett skivbolag någonsin skickar dig det riktiga flerspåret eller en officiell acapella, använd den. Separation är reservlösningen när ingen stam finns.
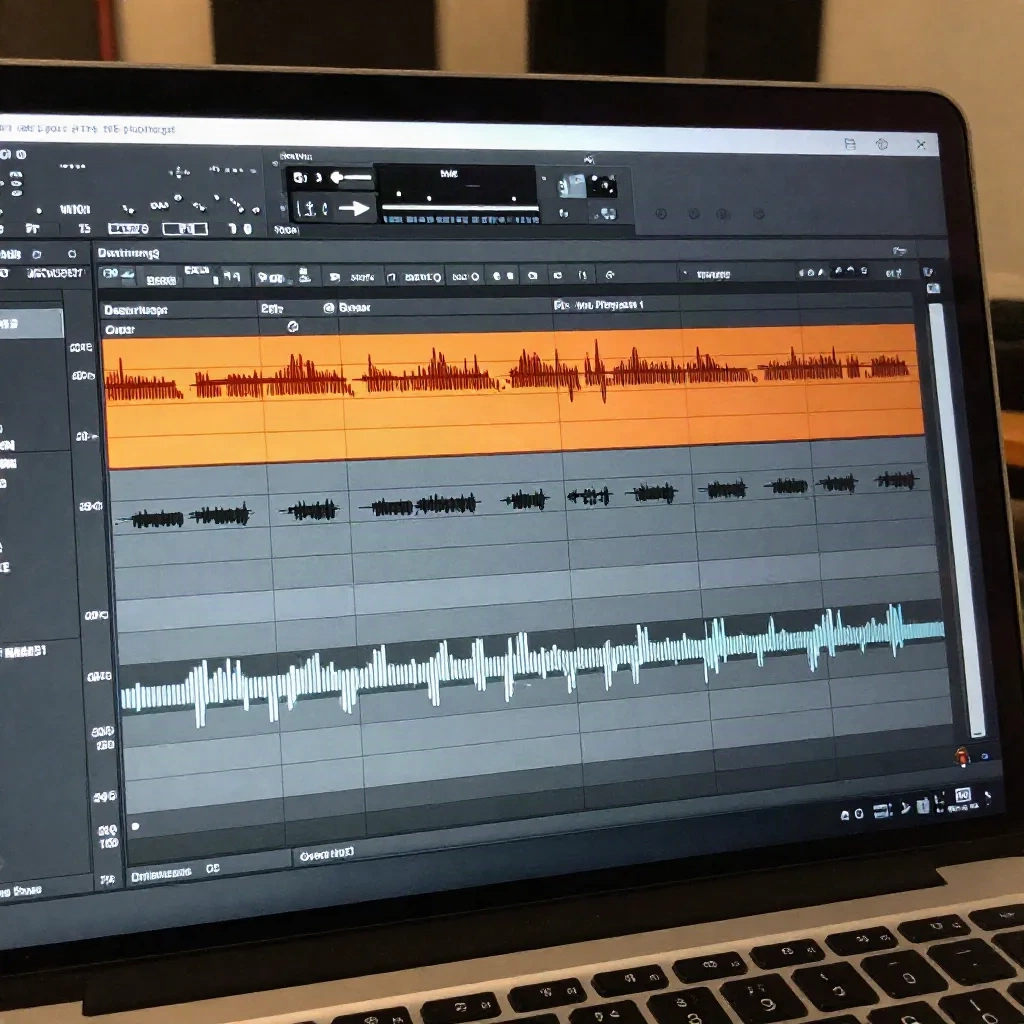
Så isolerar du sång med Demucs, steg för steg
Demucs, från Metas forskningsgrupp, är den öppna modell som de flesta separationstjänster använder under huven. Den hybrida transformerversionen rapporterar ett signal-till-distorsionsvärde (SDR) på 9.20 dB på MUSDB-benchmarken när den tränas med extra data, enligt artikeln Hybrid Transformers for Music Source Separation. Ett högre SDR betyder mindre kvarvarande instrument i sången och mindre skada på sången själv.
Arbetsflödet tar fyra steg:
Skaffa den bästa källfil du kan. En 16-bitars WAV eller FLAC på 44.1 kHz slår en 128 kbps MP3 varje gång, eftersom förlustkodningen redan har suddat ut de högfrekvenser som modellen använder för att hitta konsonanter.
Installera Demucs lokalt med pip, eller använd ett webbverktyg som lindar in det. Lokala körningar håller dina filer privata och kostar ingenting per låt.
Kör kommandot för två stammar:
demucs --two-stems=vocals din-latt.wav. Första körningen laddar ner modellvikterna, som är några hundra megabyte.Öppna utdatamappen. Du får
vocals.wavochno_vocals.wav. Lägg in båda i din DAW, placera dem så att de startar vid sample noll, och kontrollera att summan återskapar originalet.
På en modern laptop-CPU tar en fyra minuter lång låt cirka en till tre minuter. En GPU gör det på några sekunder. Varianten htdemucs_ft är ungefär fyra gånger långsammare och något renare på sång. Använd den för allt du tänker släppa eller klona från.
Namnge filerna efter låt och körning, till exempel låtnamn_htdemucs_ft. Har du kört flera varianter av samma låt blir det annars lätt att jämföra fel filer. Spara också källfilen orörd bredvid stammarna, så att du kan köra om med en annan modell utan att leta upp originalet igen.
Vad den isolerade sången fortfarande missar
Så här låter utdata i sitt sammanhang. Solo:a sångstammen så hör du tre återkommande artefakter.
Efterklangen kapas. Modellen behåller den torra sången och tappar mycket av rummet, så slutet på varje fras stannar abrupt. En kort faltningsreverb på 10 till 15 procent wet limmar ihop den igen.
Hi-hats och sibilanser byter plats. Cymbalenergi kring 8 till 10 kHz läcker in i sången, och en del riktiga s-ljud läcker ut. En de-esser på 6 till 8 kHz plus en försiktig dynamisk EQ-klippning hanterar det mesta.
Bakgrundssång och dubbleringar hamnar i fel stam. Modellen kan inte veta vilken röst du kallar huvudrösten. Starkt staplade refränger kommer ut som en enda utsmetad vokal.
Lita inte på den som säger att resultatet är rent. Separation är en uppskattning, inte en återställning av originalspåren.
Spelar inställningar och källfil verkligen roll?
Ja, och mer än valet av verktyg. Tre saker flyttar resultatet.
Källkvaliteten kommer först. Kör samma låt från en förlustfri fil och från en MP3 med låg bitrate, och null-testa sångstammarna mot varandra. MP3-versionen bär hörbar pre-echo runt plosiver.
Modellvalet kommer på andra plats. Finjusterade Demucs-varianter och nyare band-split-modeller byter hastighet mot färre artefakter. Den äldre Spleeter-modellen från Deezer är snabb och lätt, men sången låter plattare på allt med ett tätt arrangemang.
Överlapp och shift-inställningar kommer på tredje plats. En högre överlappning (0.25 som standard) och två till fem slumpmässiga shifts jämnar ut gränsartefakter, till priset av körtid. För en slutlig export, höj båda.
Ett praktiskt sätt att spara tid är att testa på ett kort utdrag först. Ta de första 30 sekunderna av refrängen, kör separationen med standardinställningarna och lyssna. Bubblar sången redan där, höj överlappningen och kör om bara utdraget innan du kör hela låten. Då slipper du vänta flera minuter på ett resultat som ändå måste göras om.
Kan du använda en isolerad sång som röstklonningssample?
Det här är vad läsarna oftast frågar. Kort svar: bara med tillstånd, och sällan i full kvalitet.
En klon tränad på en separerad sång ärver artefakterna. Kapad efterklang och sibilansläckage syns som märkliga andningsljud eller läspning i det genererade talet. De flesta klonningstjänster vill ha 30 sekunder till 3 minuter torrt, närmikrofonerat tal utan musik under. En separerad låtsång är sjungen, processad och efterklangsbehandlad, alltså motsatsen.
Den juridiska sidan är lika snäv. En kommersiell inspelning skyddas av upphovsrätt, och sångarens röst kan skyddas av personlighets- eller publicitetsrätt beroende på land. Att klona en sångare från en utgiven låt utan licens är just det användningsfall som lagstiftare börjar skriva regler om. Använd dina egna inspelningar, eller en samtyckande artist, för alla kloner du levererar.
Där isolering faktiskt hjälper är när du städar ditt eget material. Om du spelat in en intervju över en musikbädd, eller ett röstmemo med ett bakgrundsspår, ger separation en renare startpunkt innan du laddar upp ett sample.
När ska du hoppa över AI-separation helt?
Hoppa över den när du kan få den riktiga stammen. Många artister publicerar stammar för remixtävlingar, och butiker som Bandcamp säljer officiella acapellor. En riktig stam har inga artefakter alls.
Hoppa över den för forensiskt eller bevisrelaterat arbete. En separerad sång är modellens gissning, och den kan hitta på rimliga detaljer.
Hoppa över den också när sången är det enda i mixen med samma klangfärg som instrumenten, till exempel en ensam sångare som dubblerar en synthslinga. Nätverket ger dig båda, blandade.
Värt besväret är en övningsversion, ett sample till en remix du tänker klara rättigheterna för, ett karaokespår eller en städning av din egen inspelning.
En städkedja för den extraherade sången
Behandla stammen som en grov bounce, inte en färdig låt. Det här är ordningen vi använder vid varje extraktion.
Börja med ett högpassfilter på 80 Hz för att ta bort kickläckage. Sång bär nästan ingenting användbart under det, och modellen lämnar ofta ett svagt lågt dunk kvar.
Använd sedan ett spektralreparationsverktyg eller en dynamisk EQ på läckagebanden. Hi-hat-läckage ligger kring 8 till 10 kHz, virveltrumman kring 200 Hz och 4 kHz. Klipp bara medan den störande träffen spelas, så att sången behåller sin luft mellan träffarna.
Lägg sedan till en de-esser på 6 till 8 kHz, lite plattreverb för att återskapa svansarna och en lätt kompressor på 2:1 för att jämna ut nivåhopp där modellen bytte säkerhet. Ändringarna ska vara små. 1 till 3 dB gain reduction räcker gott.
Avsluta med en loudnesskontroll. Isolerade sånger blir tystare än originalmixen, vanligtvis 6 till 10 dB, så normalisera innan du jämför med något annat.
Sessionsanteckning: lyssna alltid på stammen i hörlurar och i högtalare. Artefakter som försvinner i högtalarna syns i hörlurarna.
Är separationen tillräckligt bra? Två kontroller tar fem minuter. Först null-testet: invertera fasen på summan av båda stammarna mot originalet. En trogen uppdelning lämnar en mycket svag rest. Sedan solotestet: lyssna på sången ensam i måttlig volym och notera var den darrar, för de ställena syns i alla remixer.
Om det darrar bara i refrängen, kör om med högre överlappning eller dela upp sektionen separat. Om det darrar överallt är källfilen eller arrangemanget begränsningen, och ingen inställning fixar det.
Inte allt behöver en kommandorad. Välj verktyg efter uppgift.
För batchstädning av egna talade inspelningar är en transkriptbaserad redigerare som också tar bort bakgrundsmusik snabbare än en stamseparation.
För att bygga ett klonningssample av ren tal, använd en tjänst som tar emot 30 sekunder till några minuter torrt ljud och rapporterar kvalitet innan du binder dig.
Innan nästa session
Kör ett test innan du satsar på ett arbetsflöde. Ta en låt du äger, dela den med htdemucs_ft och summera de två stammarna igen. Null-testa dem mot originalet. Om resten ligger under cirka -40 dB är uppdelningen tillräckligt trogen för de flesta jobb.
Åtgärda sedan de tre kända problemen i ordning: lägg till en kort reverb, de-essa kring 6 till 8 kHz och bestäm vilka dubbleringar du behåller. Det tar tio minuter och flyttar sången från "uppenbart extraherad" till användbar i en mix.
Håll till sist en tydlig gräns mellan att städa ditt eget ljud och att låna någon annans röst. Det första är ett arbetsflöde. Det andra kräver en licens.